Anthropic เปิดตัว Claude Sonnet 5.5 ราคาเท่าเดิม แต่เร็วขึ้นและใช้ token น้อยลง
Claude Sonnet 5.5 โมเดลตัวที่สองของตระกูล Claude 5.5 ราคาต่อ token เท่ากับ Sonnet 5 ทุกรายการ สิ่งที่เปลี่ยนคือสร้างผลลัพธ์เร็วขึ้นกว่า 30% และทำงานเดียวกันโดยใช้ token น้อยลง พร้อมคะแนน benchmark ที่ขยับขึ้นแบบก้าวกระโดด
โดย ณัฐพล ยงค์ไพบูลย์ผู้ร่วมก่อตั้งกลุ่ม Claude Thailand Community
Anthropic เปิดตัว Claude Sonnet 5.5 โมเดลตัวที่สองของตระกูล Claude 5.5 ต่อจาก Opus 5.5 ที่ออกมาก่อนหน้านี้
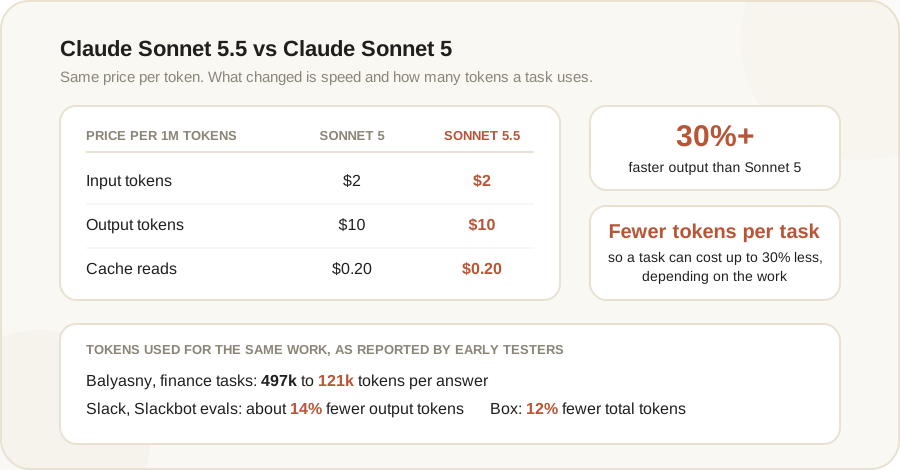
เรื่องแรกที่ควรรู้คือ ราคาไม่ได้ลด Sonnet 5.5 คิดราคาเท่ากับ Sonnet 5 ทุกรายการ คือ input 2 ดอลลาร์ output 10 ดอลลาร์ และ cache read 0.20 ดอลลาร์ต่อล้าน token สิ่งที่ดีขึ้นจริงมีสองอย่าง คือสร้างผลลัพธ์เร็วขึ้นกว่า 30% และทำงานเดียวกันโดยใช้ token น้อยลง
ตำแหน่งของ Sonnet 5.5 คือตัวที่เร็วกว่าและประหยัดกว่า Opus 5.5 โดย Opus 5.5 ยังเป็นตัวหลักสำหรับงานซับซ้อนที่ต้องใช้วิจารณญาณ ส่วน Sonnet 5.5 เก่งที่สุดกับงานประจำวันที่ขอบเขตชัดเจน งานแก้บั๊ก และงานสร้างเอกสาร สไลด์ และสเปรดชีตให้ออกมาเรียบร้อย Anthropic เสริมว่าโมเดลตัวนี้มีสายตาด้านงานออกแบบที่ดีด้วย
ราคาไม่ลด แล้วบิลจะลดไหม
ค่าใช้จ่ายของการใช้ AI คิดจาก ราคาต่อ token คูณด้วยจำนวน token ที่ใช้ รอบนี้ตัวแรกเท่าเดิม แต่ตัวหลังลดลง เพราะ Sonnet 5.5 ทำงานเดียวกันจบโดยใช้ token น้อยกว่า Sonnet 5 บิลรวมจึงมีโอกาสลดลงแม้ราคาจะไม่เปลี่ยน
Anthropic ระบุว่าจากการทดสอบของตัวเอง ค่าใช้จ่ายต่องานลดลงได้สูงสุด 30% คำว่า “สูงสุด” สำคัญ เพราะตัวเลขนี้คือกรณีที่ดีที่สุด ไม่ใช่ส่วนลดที่ได้ทุกครั้ง ผลจริงขึ้นอยู่กับว่าใช้ทำงานแบบไหน ดูได้จากตัวเลขของผู้ทดสอบที่ต่างกันมาก
- Balyasny Asset Management ทดสอบงานการเงิน 2,441 งาน Sonnet 5.5 ใช้ราว 121,000 token ต่อคำตอบ ขณะที่ Sonnet 5 ใช้ 497,000 token
- Slack ทดสอบกับ Slackbot โดยไม่แก้ prompt เดิม ใช้ output token น้อยลงราว 14% และได้ผลดีขึ้นเกือบทุกชุดทดสอบ
- Box ใช้ token รวมน้อยลง 12% พร้อมบอกว่าแม่นยำขึ้นและเร็วขึ้น 2.4 เท่า
- Base44 ทดสอบสร้างแอปจริง 118 ตัว Sonnet 5.5 ใช้เฉลี่ย 3.6 รอบต่อหนึ่งแอป ขณะที่ Opus 5 ใช้ 7.7 รอบ
ต่างจาก Opus 5.5 ที่ลดราคาต่อ token ลงจริง 20% แล้วยังใช้ token น้อยลงด้วย ส่วน Sonnet 5.5 ราคาเดิม ประหยัดได้เฉพาะจากการใช้ token น้อยลงเท่านั้น
คะแนน benchmark
- Terminal-Bench 4.0 (งานเขียนโค้ดแบบ agentic) ได้ 70.6% เทียบกับ Sonnet 5 ที่ 10.3% และสูงกว่า Opus 5.5 ที่ 66.4% ด้วย
- GDPval-AA v2.1 (งานอาชีพจริง 44 สาขา) ได้ 1844 ห่างจาก Opus 5.5 ที่ 1846 อยู่แค่ 2 คะแนน และทิ้ง Sonnet 5 ที่ 1449 ราว 400 คะแนน
- CursorBench 4.0 ได้ 55.5% เทียบ Sonnet 5 ที่ 34.1% และ Opus 5.5 ที่ 57.8%
- OSWorld 2.1 (การใช้คอมพิวเตอร์) ได้ 80.1% เทียบ Sonnet 5 ที่ 57.0%
- เป็น Sonnet ตัวแรกที่เล่น Pokémon Red จนจบได้ โดยดูจากภาพหน้าจออย่างเดียว
Anthropic ระบุไว้ตรง ๆ ว่าคะแนน benchmark สะท้อนความสามารถได้แค่ด้านเดียว และจากการทดสอบของทั้งทีมงานเองและผู้ทดสอบภายนอก Opus 5.5 ยังเหนือกว่าชัดเจนในงานที่ซับซ้อน ปลายเปิด และต้องใช้วิจารณญาณต่อเนื่องยาว ๆ
งานเอกสารและงานออกแบบ
ผู้ทดสอบกลุ่มแรกพูดถึงเรื่องที่วัดเป็นคะแนนไม่ได้ เช่น คุยด้วยแล้วเป็นธรรมชาติขึ้น และมีสายตาด้านงานออกแบบ ช่วยให้หน้าตาของ UI ดูเรียบร้อยขึ้น และทำสไลด์ตามเทมเพลตที่ให้ไว้ได้จนแทบไม่ต้องแก้
Anthropic ยกตัวอย่างการทดสอบภายใน โดยให้เอกสารผลประกอบการรายไตรมาสของบริษัทมหาชนแห่งหนึ่ง พร้อมบทถอดเสียงการประชุมนักวิเคราะห์และเทมเพลตสไลด์ แล้วสั่งให้ทำรายงานสรุปผลการดำเนินงาน 10 สไลด์ ผู้เชี่ยวชาญ 2 คนตัดสินว่าฉบับร่างแรกส่งงานได้เลยโดยไม่ต้องแก้
ความปลอดภัย
บนชุดทดสอบพฤติกรรมอัตโนมัติราว 1,850 สถานการณ์ Sonnet 5.5 ทำได้ดีขึ้นหรือเท่าเดิมเมื่อเทียบกับ Sonnet 5 ในเกือบทุกด้าน และในชุดทดสอบเรื่องการพยายามออกนอกขอบเขตที่กันไว้ ทำได้ใกล้เคียง Opus 5.5 ซึ่งเป็นตัวที่ดีที่สุดที่ Anthropic เคยทดสอบ
เนื่องจากความสามารถด้านความปลอดภัยไซเบอร์ของ Sonnet 5.5 ขยับขึ้นมาใกล้เคียง Opus 5 จึงเป็น Sonnet ตัวแรกที่มีมาตรการกำกับด้านไซเบอร์ ติดมาด้วย งานที่มีความเสี่ยงสูงจะถูกส่งกลับไปให้ Sonnet 5 ทำแทนแบบเห็นได้ชัด ส่วนงานพัฒนาซอฟต์แวร์ทั่วไปไม่ได้รับผลกระทบ ด้านชีววิทยาใช้มาตรการชุดเดียวกับ Sonnet 5
ใช้ได้ที่ไหนบ้าง
เปิดให้ใช้แล้วบนทุกแพลตฟอร์ม รวมถึง Amazon Web Services, Google Cloud และ Microsoft Azure นักพัฒนาเรียกใช้บน Claude Platform ด้วยชื่อ claude-sonnet-5-5 ค่าเริ่มต้นของ effort ใน Claude Code และแอป Claude ตั้งไว้ที่ Medium ส่วน Claude Platform ตั้งไว้ที่ High
ใครที่ใช้ Sonnet แบบปิด thinking ไว้ ต้องเปลี่ยนไปใช้ค่า between_tools ก่อนย้ายมาใช้ Sonnet 5.5 ตามคู่มือการย้ายของ Anthropic
Claude Haiku 5.5 สำหรับงานปริมาณมากที่อ่อนไหวเรื่องต้นทุน จะตามมาในอีกไม่กี่สัปดาห์ข้างหน้า
มุมมองจากผู้เขียน
ถ้าดูแค่ป้ายราคา Sonnet 5.5 ไม่ได้ถูกลงเลย แต่สิ่งที่ผมว่าน่าสนใจคือการที่มันทำงานเดียวกันจบด้วย token น้อยลง อย่างเคสของ Balyasny ที่ลดจาก 497,000 เหลือ 121,000 token ต่อคำตอบ ส่วนจะประหยัดได้จริงแค่ไหนต้องลองกับงานของเราเอง เพราะตัวเลขจากผู้ทดสอบแต่ละรายต่างกันมาก ตั้งแต่ลด token ไปราว 12% ไปจนถึงราวสามในสี่ สำหรับงานประจำวันอย่างแก้บั๊ก ทำสไลด์ หรือสรุปเอกสาร ความเร็วที่เพิ่มขึ้นกว่า 30% น่าจะเป็นสิ่งที่รู้สึกได้ชัดที่สุด ส่วนงานที่ต้องคิดยาวและตัดสินใจซับซ้อน Anthropic เองก็ยังแนะนำให้ใช้ Opus 5.5 อยู่
ใครลองใช้ Sonnet 5.5 แล้วบ้างครับ รู้สึกว่าเร็วขึ้นหรือบิลลดลงจริงไหม มาเล่าให้กลุ่มฟังกันได้เลย
ข้อมูลในบทความนี้อ้างอิงจากประกาศอย่างเป็นทางการของ Anthropic ที่ anthropic.com อ่านต้นทางได้ที่ลิงก์ด้านล่าง
รับข่าวสารทางอีเมล
บทความใหม่ ข่าวอัปเดตเกี่ยวกับ Claude และประกาศกิจกรรมของชุมชน ส่งให้เป็นครั้งคราว ไม่ถี่จนรำคาญ