Anthropic เปิดตัว Claude Haiku 5.5 ถูกลงราว 75% เร็วที่สุด และปรับ effort ได้เป็นครั้งแรก
Claude Haiku 5.5 คือโมเดลขนาดเล็กที่ถูกที่สุด เร็วที่สุด และเก่งที่สุดที่ Anthropic เคยออก ค่าใช้จ่ายเฉลี่ยลดลงราว 75% จาก Haiku 4.5 พร้อมกันนี้ Anthropic ลดราคา cache read ของ Sonnet 5.5 ลงครึ่งหนึ่ง และแจกเครดิต API รายเดือนให้ผู้ใช้ Max กับ Team
โดย ณัฐพล ยงค์ไพบูลย์ผู้ร่วมก่อตั้งกลุ่ม Claude Thailand Community
Anthropic เปิดตัว Claude Haiku 5.5 โมเดลตัวที่สามของตระกูล Claude 5.5 ต่อจาก Opus 5.5 และ Sonnet 5.5 โดยบอกว่าเป็นโมเดลขนาดเล็กที่ถูกที่สุด เร็วที่สุด และเก่งที่สุดที่เคยออกมา
รอบนี้ราคาลดลงจริง ค่าใช้จ่ายเฉลี่ยของ Haiku 5.5 ต่ำกว่า Haiku 4.5 ราว 75% และเป็น Haiku ตัวแรกที่ปรับระดับ effort ได้
ประกาศเดียวกันมีข่าวดีอีก 2 เรื่อง
- Sonnet 5.5 ลดราคา cache read ลงครึ่งหนึ่ง ทำให้งานแบบ agentic ส่วนใหญ่ถูกลงราว 20%
- เครดิต API รายเดือนสำหรับผู้ใช้แพลน Max และ Team เพื่อใช้สร้างแอปและ agent บน Claude Platform
Haiku 5.5 เหมาะกับงานแบบไหน
Haiku 5.5 ออกแบบมาสำหรับงานปริมาณมากที่อ่อนไหวเรื่องต้นทุน Anthropic ยกตัวอย่างไว้ 3 กลุ่ม
- งานเร็วและงานซ้ำ ๆ เช่น สรุปเนื้อหา ย่อ context (compaction) query ฐานข้อมูล และจัดหมวดหมู่
- Subagent ในงานเขียนโค้ด ทำงานคู่กับ Opus 5.5 และ Sonnet 5.5 ที่เป็นตัวหลัก
- งานที่ต้องตอบไว เช่น customer support แบบสด และการใช้เบราว์เซอร์ เพราะเป็นโมเดลที่เร็วที่สุดของ Anthropic ในโหมดความเร็วปกติ (ยังช้ากว่า Opus ในโหมด Fast)
ราคาใหม่ แบ่งตามขนาด prompt
ราคาของ Haiku 5.5 มี 2 ขั้น ตัดกันที่ prompt 100,000 token Anthropic บอกว่าราว 90% ของ request ที่ส่งเข้า Haiku ตัวก่อนอยู่ในขั้นไม่เกิน 100,000 token
ราคาต่อ 1 ล้าน token (ดอลลาร์สหรัฐ)
| รายการ | Haiku 5.5 ไม่เกิน 100k | Haiku 5.5 เกิน 100k | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 | $2.00 |
| Output | $0.50 | $2.50 | $5.00 | $10.00 |
| Cache read | $0.01 | $0.05 | $0.10 | $0.10 |
| Cache write | $0.125 | $0.625 | $1.25 | $2.50 |
- prompt ไม่เกิน 100,000 token ราคาต่ำกว่า Haiku 4.5 ถึง 90%
- prompt เกิน 100,000 token ราคาต่ำกว่า 50%
ตัวเลข “ราว 75%” เป็นค่าเฉลี่ยที่ Anthropic คำนวณจากสัดส่วน request จริง และหักผลของ tokenizer ตัวใหม่แล้ว Haiku 5.5 ใช้ tokenizer แบบเดียวกับ Sonnet 5.5 และ Opus 5.5 จึงใช้ token ต่องานมากขึ้นเล็กน้อย ใครจะคำนวณงบเองควรเผื่อจุดนี้ไว้
คะแนน benchmark
ตารางจากประกาศของ Anthropic เทียบ Haiku 5.5 กับ Haiku 4.5, GPT-6 Luna และ Sonnet 5.5 (ใส่ไว้เป็นตัวอ้างอิง)
| การทดสอบ | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (งานอาชีพ) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (งานอาชีพ) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 offline subset (ใช้คอมพิวเตอร์) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity’s Last Exam ไม่ใช้เครื่องมือ | 45.9% | 10.2% | ไม่มีข้อมูล | 56.9% |
| Humanity’s Last Exam ใช้เครื่องมือ | 57.4% | 18.7% | ไม่มีข้อมูล | 64.5% |
| Terminal-Bench 4.0 (เขียนโค้ดแบบ agentic) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 Main (เขียนโค้ดแบบ agentic) | 46.4% | ไม่มีข้อมูล | 42.4% | 52.1% |
| Chartography ไม่ใช้เครื่องมือ (อ่านภาพและกราฟ) | 46.4% | 6.4% | 29.1% | 61.6% |
จุดที่เห็นชัดคือ Haiku 5.5 ทิ้งห่าง Haiku 4.5 ทุกรายการ แต่ยังตามหลัง Sonnet 5.5 ทุกรายการเช่นกัน โดยเฉพาะงานเขียนโค้ดที่ซับซ้อน
ปรับ effort ได้เป็นครั้งแรก
Haiku 5.5 เป็น Haiku ตัวแรกที่ปรับระดับ effort ได้ มี 5 ระดับ คือ Low, Med, High, Xhigh และ Max ผู้ใช้เลือกได้ว่าจะเน้นประหยัดหรือเน้นความฉลาด เหมือนโมเดลตัวอื่นของ Anthropic
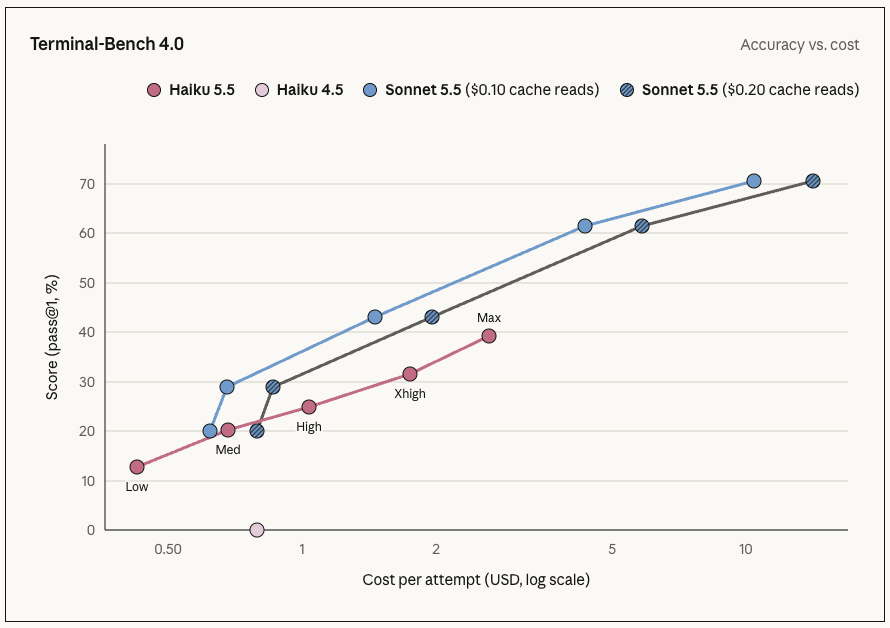
กราฟนี้บอก 2 เรื่อง
- เส้นสีชมพู (Haiku 5.5): ยิ่งเพิ่ม effort คะแนนยิ่งขึ้น จนถึง 39.2% ที่ระดับ Max ส่วน Haiku 4.5 ทำได้ 0%
- เส้นสีฟ้ากับสีเทา (Sonnet 5.5): คะแนนเท่ากัน แต่เส้นสีฟ้าซึ่งเป็นราคา cache read ใหม่อยู่ทางซ้าย คือจ่ายน้อยลงเพื่อผลลัพธ์เดิม
Anthropic ใช้กราฟนี้ย้ำว่า Sonnet 5.5 และ Opus 5.5 ยังเป็นตัวเลือกที่ดีกว่าสำหรับงานเขียนโค้ดแบบ agentic ที่ซับซ้อน ส่วน Haiku 5.5 เหมาะกับงานขอบเขตแคบ เช่น compaction สรุปเนื้อหา หรืองาน subagent ซึ่งเมื่อก่อนอาจแพงเกินไปที่จะใช้ Claude ทำ
เสียงจากผู้ทดสอบกลุ่มแรก
- Asana ทดสอบกับ AI Teammates เวลาทำงานจนเสร็จลดลงกว่า 30% และ inference ต่อรอบเร็วขึ้นสูงสุด 2.5 เท่า เทียบกับโมเดลที่ใช้อยู่
- HubSpot ได้ 92.8% เฉลี่ยจาก 3 รอบ บนชุดทดสอบงาน CRM ซึ่งเป็นคะแนนสูงสุดที่เคยเห็นบนชุดนี้
- AlphaSense ทดสอบ 400 คำถามกับฟีเจอร์ถามตอบในเอกสารที่มีการเรียกราว 8 ล้านครั้งต่อสัปดาห์ ได้ 0.84 เทียบกับ 0.76 ของ Haiku 4.5
- Box ได้คะแนนสูงกว่า Haiku 4.5 อยู่ 11 คะแนน โดยใช้เวลาราวครึ่งหนึ่ง
- Rogo ใช้เป็น subagent ดึงตัวเลขจากเอกสาร 10-K ระหว่างที่โมเดลตัวใหญ่ทำสไลด์
- Cognition ใช้เป็นตัวช่วยใน Devin Fusion คู่กับ Opus 5.5 ได้คะแนน FrontierCode 66.2 โดยลดต้นทุนและเวลา
Sonnet 5.5 ลดราคา cache read ครึ่งหนึ่ง
เริ่มวันนี้ ราคา cache read ของ Sonnet 5.5 ลดจาก $0.20 เหลือ $0.10 ต่อล้าน token รายการอื่นราคาเท่าเดิม
เพราะ cache read เป็นสัดส่วนใหญ่ของ token ที่โมเดลใช้ในงานแบบ agentic Anthropic ระบุว่าการลดครั้งนี้ทำให้ค่าใช้จ่ายของ Sonnet 5.5 ในงาน agentic ส่วนใหญ่ลดลงราว 20%
เครดิต API รายเดือนสำหรับ Max และ Team
ภายในสัปดาห์นี้ Anthropic จะทยอยเปิดเครดิต API รายเดือนให้ผู้ใช้แพลน Max และ Team สำหรับใช้บน Claude Platform
| แพลน | เครดิตต่อเดือน |
|---|---|
| Max 5x | $100 |
| Max 20x | $200 |
| Team | สูงสุด $500 ใช้ร่วมกันทั้งทีม |
เครดิตนี้มีไว้ให้ทดลองสร้างเครื่องมือ แอป และ agent ที่เรียก API และใช้ได้กับทุกโมเดล
สำหรับนักพัฒนา SDK ของ Claude ทั้ง Python และ TypeScript เพิ่มการรองรับ computer use และ browser use แบบ beta ด้วย ซึ่ง Anthropic บอกว่า Haiku 5.5 เหมาะกับงานแบบนี้เป็นพิเศษ
ความปลอดภัย
- Alignment: ดีขึ้นมากจาก Haiku 4.5 ในเกือบทุกการประเมิน พบพฤติกรรมที่ไม่ตรงเป้าหมายน้อยลงมาก และยอมร่วมมือกับการใช้งานในทางที่ผิดน้อยลง
- ไซเบอร์: มาตรการเข้มกว่า Haiku 4.5 แต่ผ่อนกว่าโมเดลรุ่นใหม่ตัวอื่นเล็กน้อย อนุญาตงานเชิงป้องกันได้กว้างกว่า Sonnet 5.5 แต่ยังบล็อก penetration testing และเทคนิคที่ผู้โจมตีมักใช้
- ชีววิทยา: ใช้มาตรการชุดเดียวกับ Sonnet 5, Sonnet 5.5 และ Opus 5
ใช้ได้ที่ไหนบ้าง
เปิดให้ใช้แล้วบนทุกแพลตฟอร์ม รวมถึง Amazon Web Services, Google Cloud และ Microsoft Azure นักพัฒนาเรียกใช้บน Claude Platform ด้วยชื่อ claude-haiku-5-5 และมีคู่มือการย้ายจากรุ่นเดิมให้
มุมมองจากผู้เขียน
ผมว่าตัวเลขที่ควรจำจากข่าวนี้คือเส้น 100,000 token เพราะราคาต่างกัน 5 เท่าระหว่างสองขั้น ใครออกแบบระบบที่ใช้ Haiku 5.5 ถ้าคุม prompt ให้ไม่เกินเส้นนี้ได้ ต้นทุนจะต่ำมาก input ล้าน token ละ 10 เซนต์ทำให้งานอย่างจัดหมวดหมู่ข้อความ สรุปเอกสารจำนวนมาก หรือให้ subagent ไปค้นข้อมูล กลายเป็นงานที่ทำได้ในปริมาณที่เมื่อก่อนไม่คุ้ม
แต่ไม่ควรอ่านข่าวนี้ว่า Haiku 5.5 มาแทน Sonnet ได้ คะแนน Terminal-Bench 39.2% เทียบกับ 70.6% บอกชัดว่างานเขียนโค้ดที่ซับซ้อนยังเป็นงานของ Sonnet 5.5 และ Opus 5.5 วิธีใช้ที่ Anthropic เองแนะนำคือให้ตัวใหญ่คิด แล้วให้ Haiku ทำงานย่อย
สำหรับสมาชิกกลุ่มที่ใช้แพลน Max เครดิต API เดือนละ $100 ถึง $200 เป็นโอกาสดีที่จะลองสร้างแอปหรือ agent ของตัวเองโดยไม่ต้องเติมเงินแยก ใครลอง Haiku 5.5 แล้วได้ผลยังไง มาเล่าให้กลุ่มฟังกันได้ครับ
ข้อมูลในบทความนี้อ้างอิงจากประกาศอย่างเป็นทางการของ Anthropic ที่ anthropic.com ตัวเลข benchmark ทั้งหมดเป็นตัวเลขที่ Anthropic รายงาน อ่านต้นทางได้ที่ลิงก์ด้านล่าง
รับข่าวสารทางอีเมล
บทความใหม่ ข่าวอัปเดตเกี่ยวกับ Claude และประกาศกิจกรรมของชุมชน ส่งให้เป็นครั้งคราว ไม่ถี่จนรำคาญ