Anthropic เปิดตัว Claude Fable 5.2 และ Mythos 5.2 ราคาถูกลง 20% เร็วขึ้น 30% และทำคะแนน FrontierCode สูงสุด
Anthropic เปิดตัว Claude Fable 5.2 และ Mythos 5.2 เก่งขึ้นทั้งเขียนโค้ด การให้เหตุผล และการมองภาพ สร้างผลลัพธ์เร็วขึ้นสูงสุด 30% ราคาลดเหลือ 8 และ 40 ดอลลาร์ต่อล้าน token Fable 5.2 ใช้ได้วันนี้ทุกแพลตฟอร์ม ส่วน Mythos 5.2 เปิดให้เฉพาะองค์กรที่ผ่านการคัดกรอง
โดย ณัฐพล ยงค์ไพบูลย์ผู้ร่วมก่อตั้งกลุ่ม Claude Thailand Community
Anthropic เปิดตัว Claude Fable 5.2 และ Claude Mythos 5.2 เมื่อวันที่ 9 พฤศจิกายน 2026
ทั้งสองตัวเป็นโมเดลเดียวกัน ต่างกันที่ระบบป้องกัน
- Fable 5.2 มีระบบป้องกันด้านความปลอดภัยไซเบอร์และชีววิทยาที่เข้มกว่า เปิดให้ทุกคนใช้
- Mythos 5.2 มีระบบป้องกันน้อยกว่า เปิดให้เฉพาะองค์กรที่ผ่านการคัดกรอง
Anthropic วางทั้งสองตัวไว้สำหรับงานเทคนิคที่ใหญ่และเปิดกว้างที่สุด สำหรับงานโค้ดและงานความรู้ทั่วไป Anthropic แนะนำให้เริ่มจาก Claude Opus 5.5 ก่อน แล้วค่อยขยับขึ้นไป Fable หรือลงมา Sonnet 5.5 หรือ Haiku 5.5 ตามความจำเป็น
มีอะไรใหม่
- เก่งขึ้น ทั้งเขียนโค้ด การให้เหตุผล และการมองภาพ ผู้ทดสอบบอกว่าอธิบายสิ่งที่ทำได้ชัดเจนขึ้น
- เร็วขึ้น สร้างผลลัพธ์เร็วกว่า Fable 5.1 และ Mythos 5.1 สูงสุด 30%
- ประหยัด token ขึ้น ที่ effort ระดับ Medium ซึ่งเป็นค่าเริ่มต้นในแอป Claude และ Claude Code Fable 5.2 ใช้ token น้อยกว่า Fable 5.1
- ทำงานร่วมกับโมเดลเล็กได้ Fable 5.2 ทำหน้าที่เป็นที่ปรึกษา (Advisor) ให้โมเดลที่เล็กกว่า หรือเป็นผู้ประสานงาน (Orchestrator) ที่แจกงานง่าย ๆ ให้โมเดลอื่นทำได้
ราคา
| Input | Output | |
|---|---|---|
| ราคาปกติ | 8 ดอลลาร์ต่อล้าน token | 40 ดอลลาร์ต่อล้าน token |
| Fast mode (สร้าง token เร็วขึ้นสูงสุด 2.5 เท่า) | 16 ดอลลาร์ต่อล้าน token | 80 ดอลลาร์ต่อล้าน token |
ราคาปกติถูกกว่าFable 5.1 ซึ่งอยู่ที่ 10 และ 50 ดอลลาร์ต่อล้าน token ราว 20%
คะแนนสูงขึ้น โดยใช้เงินน้อยลง
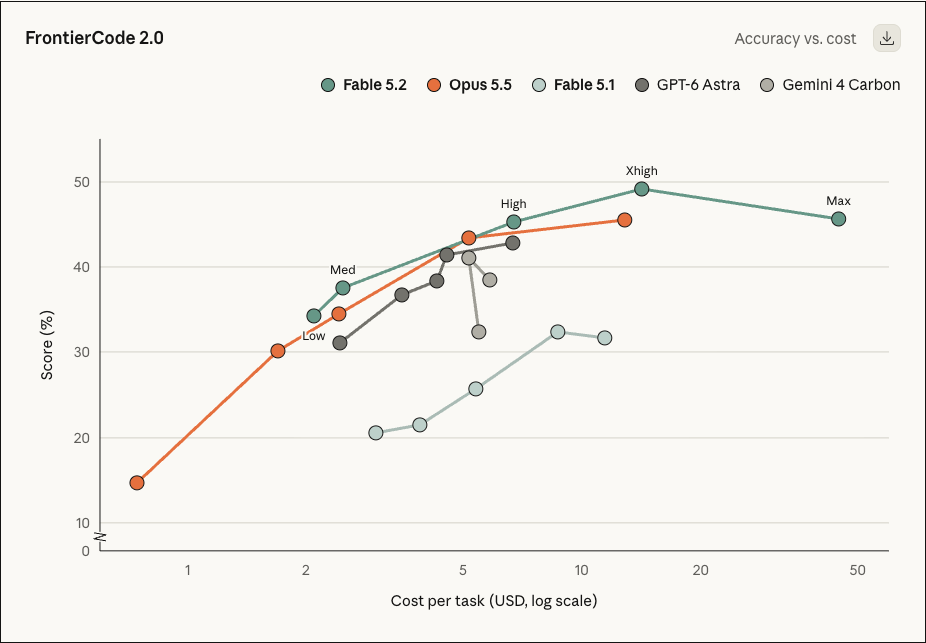
FrontierCode 2.0 วัดว่าโค้ดที่โมเดลแก้พร้อม merge แค่ไหน ให้คะแนนโดยผู้ดูแลโปรเจกต์ open source
- Effort ระดับ High Fable 5.2 ได้ 45.3% เกือบเท่าคะแนนสูงสุดของ Opus 5.5 (45.5%) แต่ใช้เงินต่องานราวครึ่งเดียว และสูงกว่าคะแนนสูงสุดของ GPT-6 Astra (42.8%) ที่ต้นทุนใกล้กัน
- Effort ระดับ Xhigh Fable 5.2 ได้ 49.1% สูงที่สุดในบรรดาโมเดลที่เปิดตัวแล้วซึ่ง Anthropic ทดสอบ
ผลแบบเดียวกันในชุดทดสอบอื่น
- HLE ที่ effort ระดับ Low ได้เท่าคะแนนสูงสุดของ Opus 5.5 ด้วยต้นทุนไม่ถึงหนึ่งในสิบ
- Chartography ที่ effort ระดับ Medium ได้ 66.4% สูงกว่า Opus 5.5 ที่ Max (64.4%) ด้วยต้นทุนไม่ถึงหนึ่งในสิบ
คะแนนเทียบโมเดลอื่น
คะแนนที่ effort สูงสุดของแต่ละโมเดล ยกเว้นที่ระบุไว้
| ชุดทดสอบ | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| Remote Labor Index (High) | 41.3% | 17.9% | 21.3% | 20.8% | - |
| Humanity’s Last Exam (ใช้ tools) | 74.2% | 65.6% | 67.7% | 57.2% | - |
| Chartography (ไม่ใช้ tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Fable 5.2 นำเกือบทุกชุดทดสอบในตาราง ยกเว้น AutomationBench ที่ Gemini 4 Carbon ได้คะแนนสูงกว่า
ตัวอย่างงานที่ Anthropic เล่าไว้
- โค้ด โค้ดที่ merge เข้า codebase หลักของ Anthropic ตอนนี้ Claude เขียนเกิน 90% วิศวกรคนหนึ่งใช้ Fable 5.2 ออกแบบระบบปฏิบัติการต้นแบบที่บูตบนแล็ปท็อปได้ โดยประสานงาน subagent กว่า 1,000 ตัวนาน 8 วัน
- คณิตศาสตร์ ทีม agent ของ Fable 5.2 ราว 1,000 ตัว เขียนบทพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาต์ให้คอมพิวเตอร์ตรวจได้ (formalize) เสร็จใน 30 ชั่วโมง ครั้งแรกที่ Anthropic ทำใช้เวลา 11 วัน
- ฮาร์ดแวร์ Fable 5.2 ออกแบบอุปกรณ์อิเล็กทรอนิกส์ 3 ชิ้นที่ใช้งานได้จริงโดยไม่ต้องแก้วงจร
- ความปลอดภัยไซเบอร์ Mythos 5.2 ได้ 89.6% บน CVE Rediscovery พบช่องโหว่มากกว่า Opus 5.5 ราว 10.2%
ใช้ได้ที่ไหน
- Fable 5.2 ใช้ได้วันนี้ทุกแพลตฟอร์ม รวมถึง Amazon Web Services, Google Cloud และ Microsoft Azure ชื่อโมเดลใน API คือ
claude-fable-5-2 - Fable ในแพลนแบบสมัครสมาชิก แพลน Pro และที่นั่งแบบ Standard ของ Team ใช้ Fable ได้สูงสุดครึ่งหนึ่งของเพดานรายสัปดาห์ แพลนที่จ่ายเงินซึ่งเข้าเงื่อนไขได้รีเซ็ตโควตา Fable 1-3 ครั้ง ตามระยะเวลาที่เป็นสมาชิก
- Fast mode ใช้ได้ใน Claude Code, Claude Platform, Google Cloud และ Microsoft Foundry
- Mythos 5.2 เปิดให้เฉพาะองค์กรที่ผ่าน Cyber Verification Program หรือ Life Sciences Verification Program ส่วนลูกค้า Claude Enterprise ใช้ Mythos 5.2 สแกนโค้ดผ่าน Claude Security ได้
ความปลอดภัย
- บล็อกคำถามน้อยลง Fable 5.2 บล็อกคำถามน้อยกว่า Fable 5.1 ราว 55% คำถามด้านไซเบอร์หรือชีววิทยาที่ถูกบล็อก ระบบจะส่งต่อให้โมเดลรุ่นก่อนตอบแทน
- ประเมินความเสี่ยงต่ำ Anthropic ประเมินว่าความเสี่ยงที่โมเดลจะทำงานผิดเป้าหมายในเรื่องร้ายแรงอยู่ในระดับต่ำ ผู้ทดสอบภายนอกมี UK AI Security Institute และ METR
- ออกนอก sandbox น้อยลงมาก ในการทดสอบหลุดออกจาก sandbox Mythos 5.2 ใช้ข้อมูลนอก sandbox ใน 3.1% ของสถานการณ์ จากเดิม 21% ใน Mythos 5.1
รายละเอียดเต็มอยู่ใน System Card ของ Claude Fable 5.2 และ Mythos 5.2
ดูเพิ่มเรื่องการเปิดตัว Claude Opus 5.5
รับข่าวสารทางอีเมล
บทความใหม่ ข่าวอัปเดตเกี่ยวกับ Claude และประกาศกิจกรรมของชุมชน ส่งให้เป็นครั้งคราว ไม่ถี่จนรำคาญ